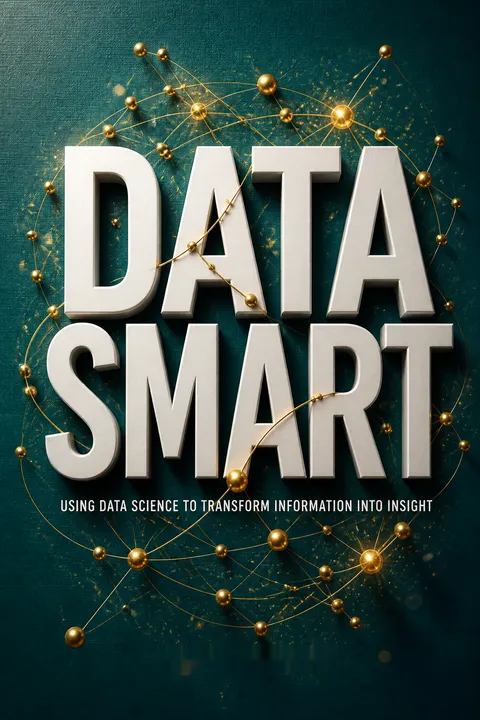


Kluczowe wnioski
Zacznij od decyzji biznesowej, a nie od modnego narzędzia do analizy danych
Zdefiniuj rzeczywisty problem. Nauka o danych w tej książce oznacza przekształcanie danych za pomocą matematyki i statystyki w użyteczne wnioski, decyzje lub produkty. Punktem wyjścia nie jest zamówienie nowego oprogramowania. Jest nim pytanie biznesowe: którą decyzję należy usprawnić i jakie informacje mogłyby ją zmienić? Różnicę tę ilustruje scena z filmu Sneakers. Bohater, poproszony o złamanie zamka z klawiaturą, zamiast tego wyważa drzwi. Prawdziwym celem było wejście do pomieszczenia, a nie złamanie zamka.
Najpierw zbuduj prototyp, dopiero potem skaluj. Arkusze kalkulacyjne pozwalają analitykom przyjrzeć się danym i przetestować techniki, nie wymagając od nich wcześniejszej nauki środowiska programistycznego. Przydają się do eksploracji, ale niekoniecznie do zastosowań produkcyjnych. Szerszym celem książki jest pomóc osobom z biznesu rozpoznać właściwe podejście analityczne i oceniać rekomendacje techniczne.
Uderza, jak wiele błędów analitycznych może pojawić się, zanim powstanie jakikolwiek model. Nawet poprawnie sformułowane obliczenie może odpowiadać na niewłaściwe pytanie, zwłaszcza gdy prośba od początku ujmuje problem w ramach założeń przyjętych przez kogoś innego. Przykład z zamkiem to zwięzła lekcja formułowania problemu: odróżniaj pożądany rezultat od proponowanej metody. Warto też zapytać, kto podejmie działania na podstawie wyniku. Jeśli żadna decyzja się nie zmieni, nawet imponująca technicznie analiza może być jedynie ozdobnikiem.
Znaczenie skupień zależy od cech i miary odległości
Podobieństwo trzeba zdefiniować. Grupowanie skupia obserwacje bez wcześniej przypisanych etykiet. W grupowaniu metodą k-średnich każdego klienta przypisuje się do najbliższego środka skupienia, a środki przesuwają się tak, by zmniejszyć łączną odległość. Przykład sprzedawcy wina zaczyna się od 100 klientów i 32 ofert. Macierz zakupów zapisuje zakupy każdego klienta jako jedynki, a ich brak jako zera. Taki sposób reprezentacji danych oraz wybrana reguła odległości wpływają na to, jakie grupy algorytm może wykryć.
Zakupy nie są jednakowo mocnym dowodem. Zwykła odległość euklidesowa traktuje wspólny brak zakupu tak samo jak wspólny zakup. Odległość cosinusowa kładzie większy nacisk na zbieżność zakupów, dzięki czemu lepiej sprawdza się w przypadku rzadkich danych o zakupach. Uzyskane grupy ujawniają zrozumiałe wzorce, takie jak miłośnicy Pinot Noir, klienci kupujący niewielkie ilości czy osoby preferujące wina musujące. Współczynnik sylwetkowy (Silhouette) pomaga porównywać przypisania do skupień, ale interpretacja przez człowieka nadal ma znaczenie.
Głębsza lekcja jest taka, że algorytm nie odkrywa segmentów klientów niezależnie od analityka. Dobór cech i miary odległości odzwierciedla założenia na temat tego, co uznajemy za podobieństwo. W danych o zakupach wspólne działanie często stanowi mocniejszy dowód preferencji niż wspólny brak działania, choć żadna z tych reguł nie jest uniwersalna. Skupienia najlepiej traktować jako hipotezy wymagające zbadania, a nie naturalne kategorie. Segment, który nie może pomóc w podjęciu odrębnej decyzji, może być matematycznie schludny, a zarazem bezużyteczny z biznesowego punktu widzenia.
Naiwny klasyfikator Bayesa zamienia nieuporządkowany tekst w użyteczne prawdopodobieństwa dzięki daleko idącym uproszczeniom
Policz słowa i porównaj klasy. Naiwny klasyfikator Bayesa klasyfikuje dokument, szacując prawdopodobieństwo wystąpienia zawartych w nim słów w każdej ze znanych kategorii. W przypadku nowego tweeta porównuje prawdopodobieństwo wystąpienia tych słów w tweecie o usłudze poczty elektronicznej Mandrill z ich prawdopodobieństwem w tweetach dotyczących innych znaczeń słowa „mandrill”. Metoda zakłada, że słowa występują niezależnie, co jest oczywiście nierealistycznym uproszczeniem. Mimo to może skutecznie klasyfikować, ponieważ model musi porównywać wyniki, a nie rozumieć język tak jak człowiek.
Przygotuj dane i ustabilizuj zliczenia. W przykładzie tweety są zamieniane na małe litery, interpunkcja zostaje usunięta, tekst podzielony na tokeny, a tokeny policzone dla każdej kategorii. Dodanie jedynki do każdego zliczenia zapobiega wyzerowaniu wyniku klasy przez słowa, które wcześniej nie wystąpiły. Logarytmowanie zamienia iloczyny bardzo małych prawdopodobieństw w łatwiejsze do obliczenia sumy. W przykładowym zbiorze testowym model w arkuszu kalkulacyjnym poprawnie sklasyfikował 19 z 20 tweetów.
Uderza użyteczna rozbieżność między założeniami modelu a jego praktycznym celem. Naiwny klasyfikator Bayesa nie rozumie ironii, szyku wyrazów ani kontekstu, a mimo to może rozróżniać kategorie, jeśli ich słownictwo wystarczająco się różni. Dlatego świetnie nadaje się na model bazowy: jest na tyle prosty, by go przeanalizować, szybki w budowie i pozwala sprawdzić, czy w danych w ogóle istnieje sygnał. Pozornych sukcesów nie należy mylić z rozumieniem języka, a wynik na 20 przykładach jest demonstracją, nie gwarancją.
Stosuj optymalizację, gdy dane mają wskazać, co zrobić dalej
Prognoza to nie decyzja. Model predykcyjny szacuje, co może się wydarzyć. Optymalizacja wybiera działanie przy uwzględnieniu ograniczeń. W przykładzie mieszania soków firma wybiera ilości soku pomarańczowego kupowane od dostawców tak, by zaspokoić popyt i spełnić wymagania dotyczące smaku przy minimalnym koszcie. Celem modelu jest koszt; ograniczenia obejmują podaż, miesięczny popyt, barwę, smak oraz wymóg zakupu co najmniej 40 procent soku od plantatorów z Florydy.
Wyraźnie określ reguły. Programowanie liniowe opisuje decyzje, cel i ograniczenia za pomocą zależności liniowych. Zbiór dopuszczalnych rozwiązań tworzy obszar geometryczny, a metoda simpleks przeszukuje jego wierzchołki, by znaleźć optimum. Decyzje całkowitoliczbowe i binarne pozwalają uwzględnić rzeczywiste warunki, takie jak konieczność użycia całych jednostek albo wybór dostawcy. Ograniczenie Big M może powiązać decyzję tak/nie z ilością, bez zapisywania nieliniowej reguły „jeśli–to”.
Optymalizacja jest potężnym narzędziem, bo ujawnia kompromisy. Menedżerowi dążącemu do obniżenia kosztów pokazuje, z jakich elementów jakości, zdolności produkcyjnych czy elastyczności dostawców trzeba zrezygnować. Dzięki temu niejasna różnica zdań zamienia się w wybór, który można skwantyfikować. Metoda ma jednak swoje granice: cel i ograniczenia odzwierciedlają decyzje ludzi, a nie prawdy odkryte przez matematykę. Nawet model rozwiązany idealnie może realizować niewłaściwy cel lub pomijać konsekwencje istotne dla klientów.
Oceń ryzyko, testując wiele możliwych scenariuszy, a nie jedną prognozę
Dane wejściowe są niepewne. Specyfikacje dostawców, popyt i warunki transportu mogą się zmieniać. Książka pokazuje, jak opisywać niepewne pomiary za pomocą rozkładów, a następnie losować wiele możliwych scenariuszy metodą symulacji Monte Carlo. W przykładzie z sokiem pomarańczowym w każdym scenariuszu losuje się wiarygodne wartości smaku i barwy na podstawie średnich i odchyleń standardowych dla dostawców. Optymalizacja musi następnie spełniać limity jakości we wszystkich tych scenariuszach, zamiast opierać się wyłącznie na wyidealizowanych wartościach średnich.
Zmierz kompromis. Gdy nie da się osiągnąć założonego kosztu bez złagodzenia wymagań jakościowych, model może minimalizować zakres tego złagodzenia. Wersja minimaksowa ogranicza najgorsze pogorszenie jakości, zamiast ukrywać poważną słabość za uspokajającą średnią. Takie podejście uwidacznia ryzyko: decydenci mogą porównać koszt z odpornością uzyskanej mieszanki, zamiast traktować niepewne dane wejściowe jak niezmienne fakty.
Wartością tego podejścia jest odejście od pytania o pojedynczy najlepszy plan na rzecz pytania, jak plan sprawdza się w różnych prawdopodobnych warunkach. To uczciwsza podstawa decyzji operacyjnych, gdy wartości średnie maskują ekspozycję na ryzyko. Metoda scenariuszowa jest jednak wiarygodna tylko na tyle, na ile wiarygodne są jej rozkłady i założenia. Sto symulowanych przypadków nie obejmuje wszystkich możliwych zakłóceń. Zakres scenariuszy, szacunki prawdopodobieństwa i koszt niepowodzenia należy dokładnie przeanalizować.
Twórz użyteczne cechy, a prognozy oceniaj na niewykorzystanych wcześniej przypadkach
Cechy niosą sygnał. Aby zidentyfikować gospodarstwa domowe, w których ktoś jest w ciąży, RetailMart łączy wskaźniki zakupowe, takie jak testy ciążowe, witaminy prenatalne, kwas foliowy i ubrania ciążowe. Żaden pojedynczy zakup nie dowodzi ciąży. Model szuka wzorca wśród niedoskonałych wskazówek. Dane kategoryczne, takie jak płeć czy typ adresu, trzeba najpierw przekształcić w numeryczne kolumny wskaźnikowe; ten proces nazywa się kodowaniem zero-jedynkowym. W przykładzie przyjęto, że 6 procent klientów jest w ciąży, ale zrównoważono próbę treningową, aby model nie sprawiał wrażenia trafnego tylko dlatego, że niemal wszystkim przypisuje kategorię „nie jest w ciąży”.
Testuj na danych spoza zbioru treningowego. Regresja uczy się współczynników na oznaczonych przykładach, a następnie oblicza wyniki dla klientów, na których nie była trenowana. Próg modelu decyduje, ilu z nich zostanie zaklasyfikowanych jako osoby w ciąży. Podniesienie progu zazwyczaj ogranicza liczbę fałszywych alarmów, ale zarazem powoduje przeoczenie większej liczby prawdziwych przypadków. Precyzja, swoistość, czułość i krzywa ROC pomagają pokazać te kompromisy.
Najważniejsza praktyczna myśl tego rozdziału jest taka, że modelowanie zaczyna się od skonstruowania danych, a nie od wyboru algorytmu. Lepsza cecha lub dokładniejsza etykieta może mieć większe znaczenie niż bardziej złożony model. Oddzielny zbiór testowy chroni też przed kuszącym błędem polegającym na chwaleniu modelu za zapamiętanie przykładów treningowych. W praktyce progi powinny odzwierciedlać koszt każdego rodzaju błędu, a wnioskowanie o wrażliwych cechach ludzi wymaga czegoś więcej niż tylko użyteczności statystycznej.
Łącz słabe reguły, gdy jeden sprytny model nie dostrzega wzorca
Proste reguły mogą się składać na dobry wynik. Drzewko decyzyjne o jednym podziale to prosty klasyfikator oparty na jednym pytaniu, na przykład o to, czy gospodarstwo domowe kupiło kwas foliowy. Przeoczy wiele przypadków, ale metody zespołowe łączą wiele takich reguł. Agregowanie modeli (bagging) polega na trenowaniu modeli na różnych losowych próbach danych, a następnie łączeniu ich głosów. Wzmacnianie (boosting) trenuje kolejne modele, które skupiają się na przypadkach błędnie sklasyfikowanych przez wcześniejsze modele.
Przykład pokazuje różne zalety tych metod. Przy użyciu 200 drzewek o jednym podziale model łączący wyniki różnych prób poprawnie wskazał około 33 procent gospodarstw domowych, w których ktoś był w ciąży, przy odsetku wyników fałszywie pozytywnych równym 1 procent. Model wzmacniany osiągnął około 85 procent czułości, przy 27-procentowym odsetku wyników fałszywie pozytywnych. Wartości te pochodzą z przykładowego zbioru danych w książce i nie oznaczają, że wzmacnianie zawsze wygrywa. Agregowanie modeli łatwiej zrównoleglić i może ono ograniczać przeuczenie; wzmacnianie może być dokładniejsze, ale może też nadmiernie dopasować się do zaszumionych przykładów.
Metody zespołowe ilustrują ogólną zasadę modelowania: różnorodność niedoskonałych składników może być bardziej użyteczna niż powtarzanie jednej metody. Agregowanie modeli zapewnia tę różnorodność przez ponowne losowanie próbek, a wzmacnianie — przez kierowanie uwagi na wcześniejsze błędy. Porównanie pokazuje też, dlaczego jedna liczba opisująca trafność nie wystarcza. Jeden punkt działania może być odpowiedni dla niedrogiej oferty marketingowej, a niedopuszczalny przy decyzji o wysokiej stawce. Nie da się oddzielić wyboru właściwej metody zespołowej od konsekwencji jej błędów.
Prognozuj poziom, trend i sezonowość, a potem pokaż niepewność
Dopasuj model do wzorca. Wygładzanie wykładnicze nadaje większą wagę nowszym obserwacjom. Proste wygładzanie wykładnicze śledzi zmieniający się poziom; metoda Holta uwzględnia trend; metoda Holta-Wintersa dodaje powtarzającą się sezonowość. W przykładzie sprzedaży mieczy trzy lata danych miesięcznych pokazują wzrost i grudniowy skok. Sprawdzenie autokorelacji błędów prognozy pomaga ujawnić, czy jakiś powtarzający się wzorzec pozostaje niewyjaśniony. Sygnał powtarzający się co 12 miesięcy przemawia za uwzględnieniem sezonowości w modelu.
Prognoza punktowa to za mało. Książka pokazuje, jak tworzyć scenariusze przyszłych błędów z wykorzystaniem oszacowanego błędu standardowego, a następnie wyznaczać przedziały predykcji za pomocą percentyli. Dla pierwszego miesiąca prognozy szacunek wynosi około 245 mieczy, a 95-procentowy przedział rozciąga się mniej więcej od 224 do 264. W dalszej przyszłości przedział staje się szerszy, pokazując, że niepewność narasta wraz z upływem czasu.
Prognozowanie przedstawiono tu jako zdyscyplinowane podejście do niepewności, a nie jasnowidztwo. Uwzględnianie po kolei poziomu, trendu i sezonowości daje analitykom praktyczny sposób wyjaśnienia, co śledzi model, a kontrola błędów może ujawnić brakującą strukturę. Przedziały predykcji są ważne, ponieważ planowanie w oparciu o jedną liczbę stwarza fałszywe wrażenie precyzji. Ich wiarygodność zależy jednak od założenia, że wcześniejsze błędy będą się powtarzać w przyszłości. Zmiana strukturalna może sprawić, że nawet starannie obliczony przedział okaże się mylący.
Szukaj obserwacji odstających w kontekście, nie tylko na krańcach rozkładu
Skrajne wartości to tylko jeden z rodzajów obserwacji odstających. Granice Tukeya wskazują nietypowo wysokie lub niskie wartości na podstawie kwartylów i rozstępu międzykwartylowego. Dobrze sprawdzają się jako szybki test wstępny dla jednowymiarowych danych o rozkładzie zbliżonym do dzwonowego. Historia pani Hadlum, której ciąża miała podobno trwać 349 dni, przy średniej wynoszącej około 266, pokazuje, że skrajna wartość może wzbudzić pytania, ale nie daje ostatecznej odpowiedzi. Niektóre anomalie znajdują się jednak między grupami, a nie na krańcach rozkładu, jak krasnolud wśród hobbitów i wysokich ludzi.
Sąsiedzi ujawniają lokalną nietypowość. W przypadku wielowymiarowych danych o pracownikach książka pokazuje, jak standaryzować miary, obliczać odległości i porównywać każdą osobę z pobliskimi współpracownikami. Lokalny współczynnik odstającego elementu (Local Outlier Factor) ocenia, czy dana osoba jest nietypowo daleko od swoich sąsiadów w porównaniu z odległością między tymi sąsiadami a ich własnymi sąsiadami. W przykładzie centrum obsługi telefonicznej metoda wskazuje zarówno wyjątkowo dobrego pracownika, jak i potencjalnie słabego, który nie wyróżniał się żadną pojedynczą miarą.
Przejście od granic do porównań z sąsiadami zmienia pytanie z „Czy ta wartość jest duża?” na „Czy ta obserwacja pasuje do swojego otoczenia?”. Ta różnica ma znaczenie w wykrywaniu nadużyć, kontroli jakości i analizie kadr, gdzie nietypowe kombinacje mogą być bardziej pouczające niż pojedyncze, spektakularnie skrajne wartości. Wynik wskazujący na obserwację odstającą nie jest jednak ani wyjaśnieniem, ani oskarżeniem. Dobry system wykrywania anomalii powinien prowadzić do analizy kontekstu, ponieważ zarówno wybitni specjaliści, jak i błędy w danych mogą wyróżniać się na tle większości.
Twórz prototypy w arkuszach kalkulacyjnych, automatyzuj w R i objaśniaj wyniki osobom wdrażającym je w praktyce
Narzędzia dobieraj do wykonywanej pracy. Arkusze kalkulacyjne pozwalają analizować obliczenia podczas nauki grupowania, regresji, prognozowania i optymalizacji. Gdy metoda jest już zrozumiała, pakiety R mogą zautomatyzować znaczną część tej samej pracy. Książka pokazuje, że za pomocą kilku funkcji w R można grupować klientów kupujących wino, dopasowywać klasyfikatory ciąży, prognozować popyt na miecze i wykrywać obserwacje odstające w danych centrum obsługi telefonicznej. To przejście od ręcznego odtwarzania każdego kroku do korzystania ze sprawdzonych implementacji.
Analiza wymaga też udziału ludzi. Przydatność modelu zależy od tego, czy firma rozumie jego dane wejściowe, dba o jakość danych i podejmuje działania na podstawie wyników. Analityk musi poznać sposób działania procesu, sprawdzić, czy pytanie zostało właściwie sformułowane, i przedstawić wynik w zrozumiały dla współpracowników sposób. Technicznie elegancki model, którego nikt nie potrafi utrzymać ani któremu nikt nie ufa, nie jest skutecznym rozwiązaniem biznesowym.
Przejście od arkusza kalkulacyjnego do kodu nie jest rywalizacją między starymi a nowymi narzędziami. To przejście od przejrzystości do powtarzalności. Arkusze ujawniają założenia, a programowanie ogranicza ręczne powtarzanie czynności i ułatwia skalowanie. Najważniejszą umiejętnością jest wiedzieć, co musi pozostać możliwe do sprawdzenia, gdy zaczynamy automatyzację. Szczególnie istotny jest nacisk książki na przekładanie wyników na zrozumiały język: analitycy zdobywają wpływ nie przez podtrzymywanie technicznej tajemniczości, lecz przez pomaganie współpracownikom zrozumieć, co wynika z analizy, a czego nie można na jej podstawie stwierdzić.
Analiza
„Mistrz analizy danych” najlepiej sprawdza się jako praktyczny przewodnik po analitycznym osądzie, a nie tylko wprowadzenie do algorytmów. Przykłady obejmują sprzedawcę wina próbującego podzielić klientów na segmenty, firmę produkującą sok pomarańczowy, która równoważy koszty i smak, sprzedawcę detalicznego wnioskującego o ciąży na podstawie zakupów oraz centrum obsługi telefonicznej poszukujące nietypowych profili pracowników. Powracająca myśl jest taka, że wybór metody, sposób reprezentacji danych i cel biznesowy są ze sobą nierozerwalnie związane. Miara odległości określa, którzy klienci zostaną uznani za podobnych; funkcja celu decyduje, jakie kompromisy będzie premiować optymalizacja; próg wyznacza, jakie błędy zaakceptuje klasyfikator.
Najskuteczniejszym zabiegiem dydaktycznym w książce jest przedstawienie zaawansowanych metod w przystępnej postaci arkuszy kalkulacyjnych. Czytelnicy mogą zobaczyć, jak powstają obliczenia, dlaczego wybory modelowe mają znaczenie i w jakich miejscach cały mechanizm może zawieść. Ta przystępność ma jednak swoją cenę: implementacje w arkuszach mogą zaciemniać subtelności numeryczne i statystyczne, a ręczne budowanie metody nie jest tym samym co jej walidacja przed wdrożeniem. Rozdział o R sygnalizuje konieczne przejście od nauki algorytmów do korzystania z niezawodnych implementacji programowych.
Przykłady pokazują też użyteczną hierarchię prac analitycznych. Najpierw trzeba zrozumieć decyzję i proces. Następnie należy przedstawić dane w taki sposób, by uwzględniały istotne różnice. Kolejnym krokiem jest wybór metody i sprawdzenie jej działania. Na końcu trzeba wyjaśnić konsekwencje osobom, które mogą podjąć działania. To podejście jest lepsze niż stawianie narzędzi na pierwszym miejscu, ale wymaga też ostrożności. Trafność predykcji nie dowodzi związku przyczynowego, a wzorzec w danych transakcyjnych sam w sobie nie uzasadnia ingerowania w czyjeś życie. Modele dziedziczą ograniczenia etykiet, cech, prób oraz decyzji instytucjonalnych.
Trwałym wkładem książki nie jest zatem żaden pojedynczy algorytm. Jest nim wypracowanie nawyku pytania, co oznaczają dane, co optymalizuje model, jaka niepewność pozostaje i kto musi skorzystać z odpowiedzi. Ta dyscyplina zwiększa użyteczność zarówno prostych, jak i zaawansowanych metod, a zarazem zmniejsza ryzyko, że staną się kosztowną grą pozorów.
Podsumowanie recenzji
Mistrz analizy danych zbiera zdecydowanie pozytywne recenzje za przystępne wprowadzenie do data science z wykorzystaniem Excela. Czytelnicy chwalą jasne wyjaśnienia Foremana, praktyczne przykłady i wciągający styl pisania. Książka omawia różne techniki analizy danych — od grupowania po prognozowanie — i przedstawia złożone zagadnienia w sposób przystępny dla początkujących. Wielu czytelników docenia praktyczne ćwiczenia w Excelu przed przejściem do R. Choć niektóre rozdziały były dla części osób trudne, większość zgadza się, że to znakomita pozycja dla tych, którzy chcą rozpocząć pracę w dziedzinie data science lub rozwinąć umiejętności analityczne.
Inni czytali również




Słowniczek
grupowanie metodą k-średnich
Grupuje obserwacje wokół centrówMetoda nienadzorowana, która przypisuje każdą obserwację do najbliższego centrum klastra, a następnie koryguje położenie centrów, aby zmniejszyć odległości wewnątrz klastrów. Liczbę klastrów, k, trzeba wybrać z góry. Wyniki zależą od użytych cech i miary odległości, dlatego uzyskane grupy należy interpretować, a nie przyjmować bezkrytycznie.
współczynnik sylwetkowy (Silhouette)
Ocenia rozdzielenie klastrówMiara jakości klastrów, która porównuje średnią odległość obserwacji od członków przypisanego jej klastra ze średnią odległością od najbliższego alternatywnego klastra. Wyniki bliskie 1 wskazują na wyraźniejszy przydział, wartości bliskie 0 oznaczają nakładanie się klastrów, a wartości ujemne sugerują, że obserwacja może lepiej pasować do innego klastra. Średnie wyniki mogą pomóc w porównaniu różnych wartości k.
grupowanie metodą k-median
Wykorzystuje zaobserwowane centra klastrówOdmiana metody k-średnich, w której centra klastrów muszą przyjmować wartości występujące w obserwacjach, zamiast być średnimi, które mogą prowadzić do ułamkowych wartości cech. W przypadku binarnych danych o zakupach książka łączy to podejście z asymetryczną miarą podobieństwa, tak aby wspólne zakupy miały większe znaczenie niż wspólne niezrealizowane zakupy.
odległość cosinusowa
Mierzy różnice we wzorcach zakupówMiara odległości służąca do porównywania wektorów na podstawie kąta między nimi. W binarnych zapisach zakupów podobieństwo cosinusowe odzwierciedla nakładanie się zakupów, skorygowane o liczbę zakupów każdego klienta; odległość cosinusowa to jeden minus to podobieństwo. Przydaje się w rzadkich danych transakcyjnych, gdy zgodność pozytywnych działań ma większe znaczenie niż zgodność braków działań.
naiwny klasyfikator Bayesa
Klasyfikuje na podstawie warunkowych zliczeń słówKlasyfikator probabilistyczny, który szacuje prawdopodobieństwo wystąpienia zaobserwowanych cech w każdej klasie, a następnie wybiera klasę z wyższym uzyskanym wynikiem. W klasyfikacji tekstu często traktuje dokument jako nieuporządkowany zbiór słów i zakłada, że słowa te są warunkowo niezależne przy danej klasie. Wygładzanie addytywne pozwala uwzględnić niewidziane wcześniej słowa, a logarytmy prawdopodobieństw ułatwiają obliczanie ich iloczynów.
ograniczenie Big M
Łączy decyzje binarne z wielkościamiTechnika programowania liniowego służąca do przedstawiania logiki warunkowej za pomocą decyzji binarnej i odpowiednio dużego ograniczenia. Na przykład zmienna wskaźnikowa może być wymuszona na wartość 1, gdy ilość produktu od dostawcy jest dodatnia, natomiast wskaźnik równy 0 wymusza zerową ilość. Ograniczenie musi być na tyle duże, by dopuścić każdą prawidłową ilość, ale nie powinno być niepotrzebnie ogromne.
modularność grafu
Ocenia przypisanie do społecznościMiara sieci, która premiuje grupowanie połączonych węzłów i obniża wynik za grupy, których strukturę można wyjaśnić przypadkowymi połączeniami. Oczekiwaną liczbę połączeń szacuje się na podstawie stopni węzłów oraz łącznej liczby krawędzi lub końców krawędzi. Maksymalizacja modularności pozwala identyfikować społeczności bez konieczności wcześniejszego ustalania ich liczby.
lokalny współczynnik odstającego elementu (Local Outlier Factor)
Porządkuje obserwacje według lokalnej nietypowościWynik odstającej obserwacji oparty na porównaniu lokalnej gęstości punktu z gęstością jego najbliższych sąsiadów. Wynik około 1 sugeruje, że punkt jest zasadniczo podobny do swojego otoczenia; wyższy wynik wskazuje, że jest mniej typowy lokalnie. W przeciwieństwie do prostego progu odległości metoda może wykryć obserwację nietypową w porównaniu z pobliskimi punktami, nawet jeśli nie jest ona globalnie skrajna.
multiplikatywne wygładzanie wykładnicze Holta-Wintersa
Prognozuje poziom, trend i sezonowośćMetoda prognozowania z wykorzystaniem wygładzania wykładniczego, która aktualizuje szacunki poziomu, trendu i powtarzających się czynników sezonowych szeregu czasowego. Efekt sezonowy mnoży prognozę bazującą na poziomie i trendzie, dzięki czemu metoda jest przydatna, gdy wahania sezonowe rosną lub maleją wraz z szeregiem. Parametry wygładzania określają, jak silnie ostatnie błędy prognozy aktualizują te szacunki.
agregowanie modeli (bagging)
Łączy modele trenowane na próbkachMetoda zespołowa, która trenuje wiele modeli predykcyjnych na różnych losowych próbkach danych treningowych, a następnie łączy ich prognozy, często przez głosowanie. Zróżnicowanie próbek pozwala uzyskać zbiór modeli zamiast powtarzanych kopii jednego modelu. Agregowanie modeli może ograniczyć wrażliwość na pojedyncze przykłady treningowe, a osobne modele można trenować równolegle.
FAQ
O czym jest książka [Mistrz analizy danych] Johna W. Foremana?
- Kompleksowy przewodnik po data science: Książka przedstawia szeroki zakres technik data science: od klasycznych metod badań operacyjnych (optymalizacji, prognozowania i symulacji) po nowoczesne uczenie maszynowe (grupowanie, wykrywanie obserwacji odstających, regresję i modele zespołowe).
- Zastosowania w biznesie: Kładzie nacisk na praktyczne, rzeczywiste problemy biznesowe i pokazuje menedżerom, analitykom oraz specjalistom ds. marketingu, jak przekształcać surowe dane w przydatne w działaniu wnioski.
- Nauka przez praktykę: Czytelnicy uczą się najpierw wdrażać metody w Excelu, a następnie przechodzą do R, by wykonywać bardziej zaawansowane analizy; dzięki temu poznają podstawy pojęciowe przed rozpoczęciem programowania.
- Zrozumienie koncepcji ważniejsze niż narzędzia: Autor podkreśla, że należy rozumieć matematykę i logikę leżące u podstaw technik, a nie tylko bezrefleksyjnie korzystać z oprogramowania.
Dlaczego warto przeczytać [Mistrza analizy danych] Johna W. Foremana?
- Łączy teorię z praktyką: Książka odczarowuje data science i ułatwia zrozumienie złożonych zagadnień dzięki szczegółowym przykładom w Excelu, zanim przejdzie do programowania.
- Koncentruje się na wpływie na biznes: Uczy, jak rozpoznawać, formułować i rozwiązywać rzeczywiste problemy biznesowe z wykorzystaniem data science, unikając niepotrzebnej złożoności technicznej.
- Przystępna dla osób nieprogramujących: Na początku nie są wymagane zaawansowane umiejętności programowania; książka jest idealna dla osób znających podstawy matematyki i arkuszy kalkulacyjnych.
- Przygotowuje do zaawansowanej analityki: Po lekturze czytelnicy są gotowi korzystać z R i innych narzędzi w skalowalnych, rzeczywistych projektach data science.
Jakie są najważniejsze wnioski z [Mistrza analizy danych] Johna W. Foremana?
- Zrozum, zanim zautomatyzujesz: Opanowanie logiki i matematyki stojących za technikami data science jest ważniejsze niż poleganie na narzędziach lub kodzie.
- Excel jako narzędzie do nauki: Arkusze kalkulacyjne świetnie nadają się do prototypowania, wizualizacji i poznawania analityki przed wdrożeniem rozwiązań na większą skalę.
- Szeroki zakres technik: Książka omawia grupowanie, regresję, optymalizację, prognozowanie, wykrywanie obserwacji odstających i modele zespołowe, zapewniając szerokie podstawy.
- Znaczenie komunikacji i kreatywności: Skuteczne data science wymaga nie tylko umiejętności technicznych, lecz także właściwego formułowania problemów, komunikacji i włączania rozwiązań w procesy biznesowe.
Jakich podstawowych umiejętności obsługi arkuszy kalkulacyjnych i Excela uczy [Mistrz analizy danych] Johna W. Foremana?
- Podstawowe operacje w Excelu: Książka omawia odwołania w formułach, formatowanie warunkowe, filtrowanie i sortowanie danych oraz używanie tabel przestawnych do agregowania danych.
- Zaawansowane formuły: Objaśnia kluczowe funkcje, takie jak WYSZUKAJ.PIONOWO, PODAJ.POZYCJĘ, INDEKS, PRZESUNIĘCIE, MIN.K/MAKS.K, a także formuły tablicowe, które służą do przekształcania i analizowania danych.
- Wizualizacja danych: Czytelnicy uczą się tworzyć wykresy i wykorzystywać formatowanie warunkowe do wizualnego badania i podsumowywania danych.
- Prototypowanie analiz: Excel służy do budowania i testowania modeli data science przed przejściem do języków programowania.
Jak [Mistrz analizy danych] Johna W. Foremana wyjaśnia grupowanie, zwłaszcza metodami k-średnich i k-median?
- Przystępne analogie: Książka posługuje się zrozumiałymi przykładami, takimi jak szkolna potańcówka, aby wyjaśnić, jak grupowanie metodą k-średnich przypisuje punkty danych do najbliższego centrum klastra.
- Zastosowania biznesowe: Grupowanie służy do segmentowania klientów na podstawie danych o zakupach z wykorzystaniem miar odległości, takich jak odległość euklidesowa i podobieństwo cosinusowe.
- Ograniczenia i ulepszenia: Omówiono problemy związane z rzadkimi lub binarnymi danymi oraz przedstawiono grupowanie metodą k-median z podobieństwem cosinusowym, które pozwala uzyskać lepszą segmentację.
- Ocena klastrów: Współczynnik sylwetkowy służy do oceny jakości klastrów i wyznaczania ich optymalnej liczby.
Czym jest współczynnik sylwetkowy i jak wykorzystuje go [Mistrz analizy danych] Johna W. Foremana?
- Miara jakości klastrów: Współczynnik sylwetkowy mierzy, jak dobrze punkt danych pasuje do przypisanego mu klastra w porównaniu z innymi klastrami. Przyjmuje wartości od -1 do 1.
- Objaśnienie obliczeń: Oblicza się go jako różnicę między średnią odległością od najbliższego sąsiedniego klastra a średnią odległością od własnego klastra, podzieloną przez większą z tych dwóch odległości.
- Wybór właściwego k: Współczynniki sylwetkowe pomagają wybrać optymalną liczbę klastrów przez porównanie wyników dla różnych wartości k.
- Zastosowanie praktyczne: Książka pokazuje, jak wykorzystać analizę współczynnika sylwetkowego w Excelu do podejmowania decyzji dotyczących segmentacji biznesowej.
Jak [Mistrz analizy danych] Johna W. Foremana omawia nadzorowane modele AI, takie jak naiwny klasyfikator Bayesa i regresja?
- Klasyfikacja naiwnym klasyfikatorem Bayesa: Książka przedstawia zastosowanie naiwnego klasyfikatora Bayesa do klasyfikacji dokumentów oraz wyjaśnia prawdopodobieństwo warunkowe, regułę Bayesa i założenie niezależności.
- Implementacja w Excelu: Czytelnicy uczą się tokenizować tekst, obliczać prawdopodobieństwa z użyciem wygładzania i klasyfikować nowe dokumenty za pomocą formuł Excela.
- Regresja liniowa i logistyczna: Książka omawia budowanie modeli regresji od podstaw, szacowanie współczynników oraz ocenę dopasowania modelu za pomocą R-kwadrat, testów F i testów t.
- Ocena jakości modeli: Wyjaśniono techniki oceny precyzji, czułości, swoistości oraz krzywe ROC dla zadań regresji i klasyfikacji.
Jak [Mistrz analizy danych] Johna W. Foremana wyjaśnia modele zespołowe, takie jak agregowanie modeli i boosting?
- Agregowanie modeli z użyciem jednowęzłowych drzew decyzyjnych: Książka pokazuje, jak tworzyć wiele prostych klasyfikatorów na losowych podzbiorach danych i łączyć ich głosy, aby poprawić trafność.
- Koncepcja boostingu: Boosting objaśniono jako iteracyjny proces, w którym każdy kolejny model skupia się na korygowaniu wcześniejszych błędów poprzez zmianę wag danych.
- Automatyzacja w Excelu: Czytelnicy uczą się korzystać z makr, aby sprawnie budować i oceniać duże zespoły modeli w Excelu.
- Ocena jakości: Książka pokazuje, jak porównywać agregowanie modeli z boostingiem za pomocą krzywych ROC, oraz omawia ich mocne strony i ograniczenia.
Jakich pojęć i narzędzi związanych z modelowaniem optymalizacyjnym uczy [Mistrz analizy danych] Johna W. Foremana?
- Podstawy programowania liniowego: Książka wyjaśnia, jak formułować problemy biznesowe za pomocą funkcji celu, zmiennych decyzyjnych i ograniczeń liniowych, posługując się przykładami takimi jak problem dział i masła.
- Zaawansowane modelowanie: Omówiono zmienne całkowitoliczbowe i binarne, ograniczenia „Big M” służące do modelowania logiki warunkowej oraz linearyzację zależności nieliniowych.
- Uwzględnianie niepewności: Przedstawiono techniki takie jak symulacja Monte Carlo i optymalizacja odporna, które pozwalają modelować ryzyko i zmienność danych wejściowych.
- Narzędzia praktyczne: Do rozwiązywania dużych problemów optymalizacyjnych w Excelu polecany jest OpenSolver.
Jak [Mistrz analizy danych] Johna W. Foremana omawia grafy sieciowe i wykrywanie społeczności?
- Podstawy grafów sieciowych: Węzły reprezentują obiekty, a krawędzie — relacje; grafy buduje się na podstawie danych, wykorzystując macierze sąsiedztwa i podobieństwa.
- Wykrywanie społeczności: Książka wyjaśnia, jak maksymalizacja modularności pozwala znajdować społeczności, zarówno z wykorzystaniem optymalizacji liniowej, jak i narzędzi takich jak Gephi.
- Upraszczanie grafu: Techniki takie jak grafy sąsiedztwa rzędu r i grafy k najbliższych sąsiadów służą do upraszczania i analizowania struktury sieci.
- Wizualizacja i analiza: Czytelnicy uczą się eksportować dane do Gephi w celu ich wizualizacji oraz interpretować wyniki modularności, by wyciągać wnioski biznesowe.
Jakie metody prognozowania omawia [Mistrz analizy danych] Johna W. Foremana i jak się je stosuje?
- Wygładzanie wykładnicze: Książka omawia proste wygładzanie wykładnicze, metodę Holta z korektą trendu oraz multiplikatywne wygładzanie wykładnicze Holta-Wintersa do prognozowania szeregów czasowych.
- Optymalizacja parametrów: Czytelnicy uczą się optymalizować stałe wygładzania i testować występowanie trendu oraz sezonowości za pomocą metod statystycznych.
- Ocena prognoz: Autokorelacje reszt sprawdza się za pomocą korelogramów, a przedziały prognozy wyznacza się z użyciem symulacji Monte Carlo.
- Wizualizacja: Wykresy wachlarzowe służą do przedstawiania niepewności prognoz i skutecznego komunikowania wyników.
Jak [Mistrz analizy danych] Johna W. Foremana uczy wykrywania obserwacji odstających w data science?
- Metody jednowymiarowe: Do wykrywania obserwacji odstających w danych o rozkładzie normalnym stosuje się ogrodzenia Tukeya oparte na kwartylach i rozstępie międzykwartylowym.
- Wyzwania związane z danymi wielowymiarowymi: Książka omawia ograniczenia prostych metod i przedstawia techniki grafowe przydatne w analizie złożonych danych.
- Wykrywanie z użyciem grafów: Wyjaśniono metody takie jak grafy k najbliższych sąsiadów, stopień wejściowy, odległość do k-tego sąsiada i lokalny współczynnik odstającego elementu (LOF), służące do identyfikowania globalnych i lokalnych obserwacji odstających.
- Zastosowanie praktyczne: Czytelnicy uczą się wdrażać te metody w Excelu i R oraz stosować je do rzeczywistych zbiorów danych w celu wykrywania oszustw i analizy jakości danych.
Jak [Mistrz analizy danych] Johna W. Foremana pomaga przejść od Excela do R w pracy z data science?
- Wprowadzenie do podstaw R: Książka omawia konsolę R, przypisywanie wartości zmiennym, wektory, macierze i ramki danych służące do przekształcania danych.
- Przygotowanie danych: Czytelnicy uczą się importować pliki CSV, obsługiwać brakujące wartości i przekształcać zmienne kategorialne w czynniki w R.
- Korzystanie z pakietów R: Przedstawiono kluczowe pakiety do grupowania, regresji, prognozowania i wykrywania obserwacji odstających, wraz z przykładami odtwarzającymi analizy z Excela.
- Zachęta do dalszej nauki: Autor podkreśla, że zrozumienie algorytmów pozwala skutecznie korzystać z zaawansowanych narzędzi, i wskazuje materiały pomocne w pogłębianiu znajomości R.
Pobierz PDF
Pobierz EPUB
.epub idealnie nadaje się do czytania e-booków na telefonach, tabletach i czytnikach.








